
KI-Server


Garantie






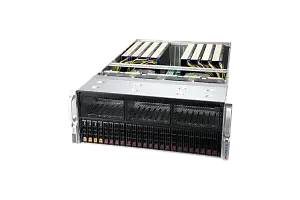


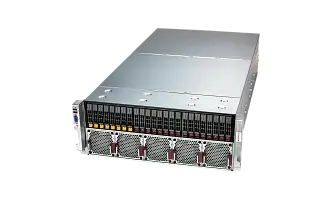


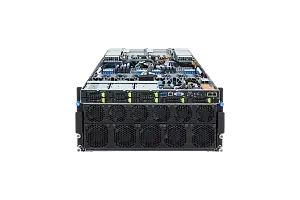

Sie können jeden Server oder Storage nach Ihren Wünschen in unserem Konfigurator oder in Absprache mit einem Experten konfigurieren. Unsere Expertise hilft uns, neue Qualitätsstandards zu setzen.
KI-Server für Training, Fine-Tuning und Inferenz auswählen
Die passende Hardware ergibt sich aus dem Modell und dem geplanten Betrieb. Beim Training zählen neben den Gewichten auch Gradienten, Aktivierungen und Optimizer-Zustände. Bei der Inferenz beeinflussen Kontextlänge und gleichzeitige Anfragen den Speicherbedarf zusätzlich. Ein KI-Server sollte deshalb für einen konkreten Arbeitsablauf und eine messbare Zielgröße ausgelegt werden.
GPU-Speicher anhand des Modells abschätzen
Ein Modell mit 70 Milliarden Parametern benötigt bei 16 Bit rechnerisch rund 140 GB allein für die Gewichte. Speicher für Laufzeit und Inferenz-Cache kommt hinzu. Für die Auswahl klären Sie zuerst, in welcher Präzision das Modell tatsächlich läuft und wie groß Kontext und Batch werden. Anschließend lässt sich entscheiden, ob eine GPU genügt, die Gewichte quantisiert werden können oder das Modell über mehrere GPUs verteilt werden muss.
Einen Server oder mehrere Knoten planen
Wenn mehrere GPUs an einem Modell arbeiten, zählen die Verbindungen im Server. Ein HGX-basierter Server kann dafür eine Plattform mit NVLink und NVSwitch bereitstellen. Sobald Sie über mehrere Knoten trainieren, kommen Netzwerkkarten, Switches und das verteilte Framework hinzu. Messen Sie bei einer Pilotkonfiguration sowohl die Leistung innerhalb eines Knotens als auch die Skalierung über das Netzwerk.
- Training. Legen Sie fest, wie viele Daten und Trainingsschritte in welcher Zeit verarbeitet werden müssen. Wählen Sie danach Präzision, Parallelisierung und Checkpoint-Speicher.
- Fine-Tuning. Beschreiben Sie die Methode. LoRA und eine vollständige Anpassung aller Gewichte stellen unterschiedliche Anforderungen an Speicher und Rechenzeit.
- Inferenz. Legen Sie ein Ziel für Antwortzeit und Durchsatz fest. Messen Sie mit realistischen Kontextlängen und gleichzeitig aktiven Anfragen.
Plattform und Software im selben Angebot vergleichen
Für eine CUDA-Umgebung kommen unter anderem Server mit NVIDIA H200 infrage. Wenn das Framework und die eingesetzten Operatoren unter ROCm laufen, bietet ein Server mit AMD Instinct MI300X eine andere Plattform zum Vergleich. Die Übersichten für Dell KI-Server und HPE KI-Server helfen, GPU-Bestückung, Kühlung und den Aufbau pro Knoten einzuordnen.
Fragen Sie einen Berater
Beginnen Sie mit Parameterzahl mal Bytes pro Gewicht. Ergänzen Sie den Speicher für Laufzeit und KV-Cache. Bei Training oder Fine-Tuning kommen je nach Verfahren weitere Zustände hinzu. Ein Test mit dem vorgesehenen Batch ist die verlässlichste Grundlage.
Die Anwendung kann Modellteile über mehrere GPUs verteilen, wenn Framework und Parallelisierungsverfahren dies unterstützen. Die Summe der Speicherkapazitäten allein genügt als Planungswert nicht.
Legen Sie zum Beispiel Tokens pro Sekunde und die tolerierbare Antwortzeit bei einer definierten Zahl gleichzeitiger Anfragen fest. Geben Sie Kontextlänge, Modell und Präzision für die Messung an.
Sobald ein Trainingsjob Daten oder Gradienten zwischen Knoten austauscht, beeinflussen Bandbreite und Latenz die Skalierung. Für getrennte Modellinstanzen ist eher die Versorgung mit Daten und Anfragen maßgeblich.
Das hängt von Framework, Version und verwendeten GPU-Operatoren ab. CUDA und ROCm sind unterschiedliche Softwareumgebungen. Testen Sie auch Erweiterungen, Inferenzserver und Container-Images auf der Zielplattform.
einen Server bei Servermall zu kaufen
Garantie
Wir möchten sicherstellen, dass unsere Geräte für Sie absolut zuverlässig sind. Deshalb werden alle unsere Geräte (auch neue) umfassend diagnostiziert, getestet und Teile ausgetauscht.
Tests
Wir statten unsere Geräte mit verschiedenen Dienstprogrammen und Software aus. Sie werden garantiert lange funktionieren.
Stromversorgung
Die Komponenten arbeiten mit voller Leistung und werden mehrere Tage lang getestet. Bei Zweifeln tauschen wir sie aus.
aller Geräte
Unsere Vorschriften sehen die gleichen Prüfungen für gebrauchte und neue Geräte vor. Übrigens: Wir ergänzen die offizielle Herstellergarantie durch unsere eigene Garantie.